Als equips de recerca mèdica no els falten dades. Els falten dades connectades. La imatge és al PACS. El quadre clínic és a la història clínica, la meitat tancat en informes d’alta de text lliure. La genòmica és un VCF en una carpeta compartida del laboratori. Les xifres de supervivència surten d’un paquet estadístic que no parla amb res de l’anterior. La literatura que ho posa tot en context viu en cent pestanyes del navegador.
Roberto Cruz
10 de juliol de 2026
Publicat originalment a LinkedIn
Cadascun d’aquests sistemes fa la seva feina. El problema és l’espai entre ells. Una pregunta de recerca que hauria de portar una tarda porta un trimestre, perquè la major part del trimestre se’n va a moure dades a mà entre buits: exportar, tornar a identificar qui és qui, enganxar una definició de cohort en tres eines que defineixen la cohort de manera diferent, tornar a calcular una xifra que algú ja va calcular el mes passat i (en silenci, a un cost alt) perdre el fil d’on va sortir realment cada resultat.
El que accelera un equip de recerca no és un model més ràpid. És tancar els buits. Un lloc on la imatge, la història, les variants, l’estadística i l’evidència són al mateix llenç, on un resultat porta la seva pròpia història, i on la maquinària de l’estudi (desidentificació, lògica de cohorts, anotació, signatura) forma part de la superfície en lloc de ser un munt de tasques paral·leles. Per això vam construir l’entorn de recerca de Tietai, i la manera més ràpida de mostrar què canvia és seguir un únic estudi des de les dades en brut fins a una troballa que podries defensar davant d’un comitè de revisió.
Un fil: una cohort de càncer de pàncrees
Agafem una pregunta amb forma real. La teràpia neoadjuvant canvia la supervivència en l’adenocarcinoma ductal de pàncrees ressecable, i podem veure’n el senyal en els nostres propis pacients abans de dissenyar-hi un assaig al voltant?
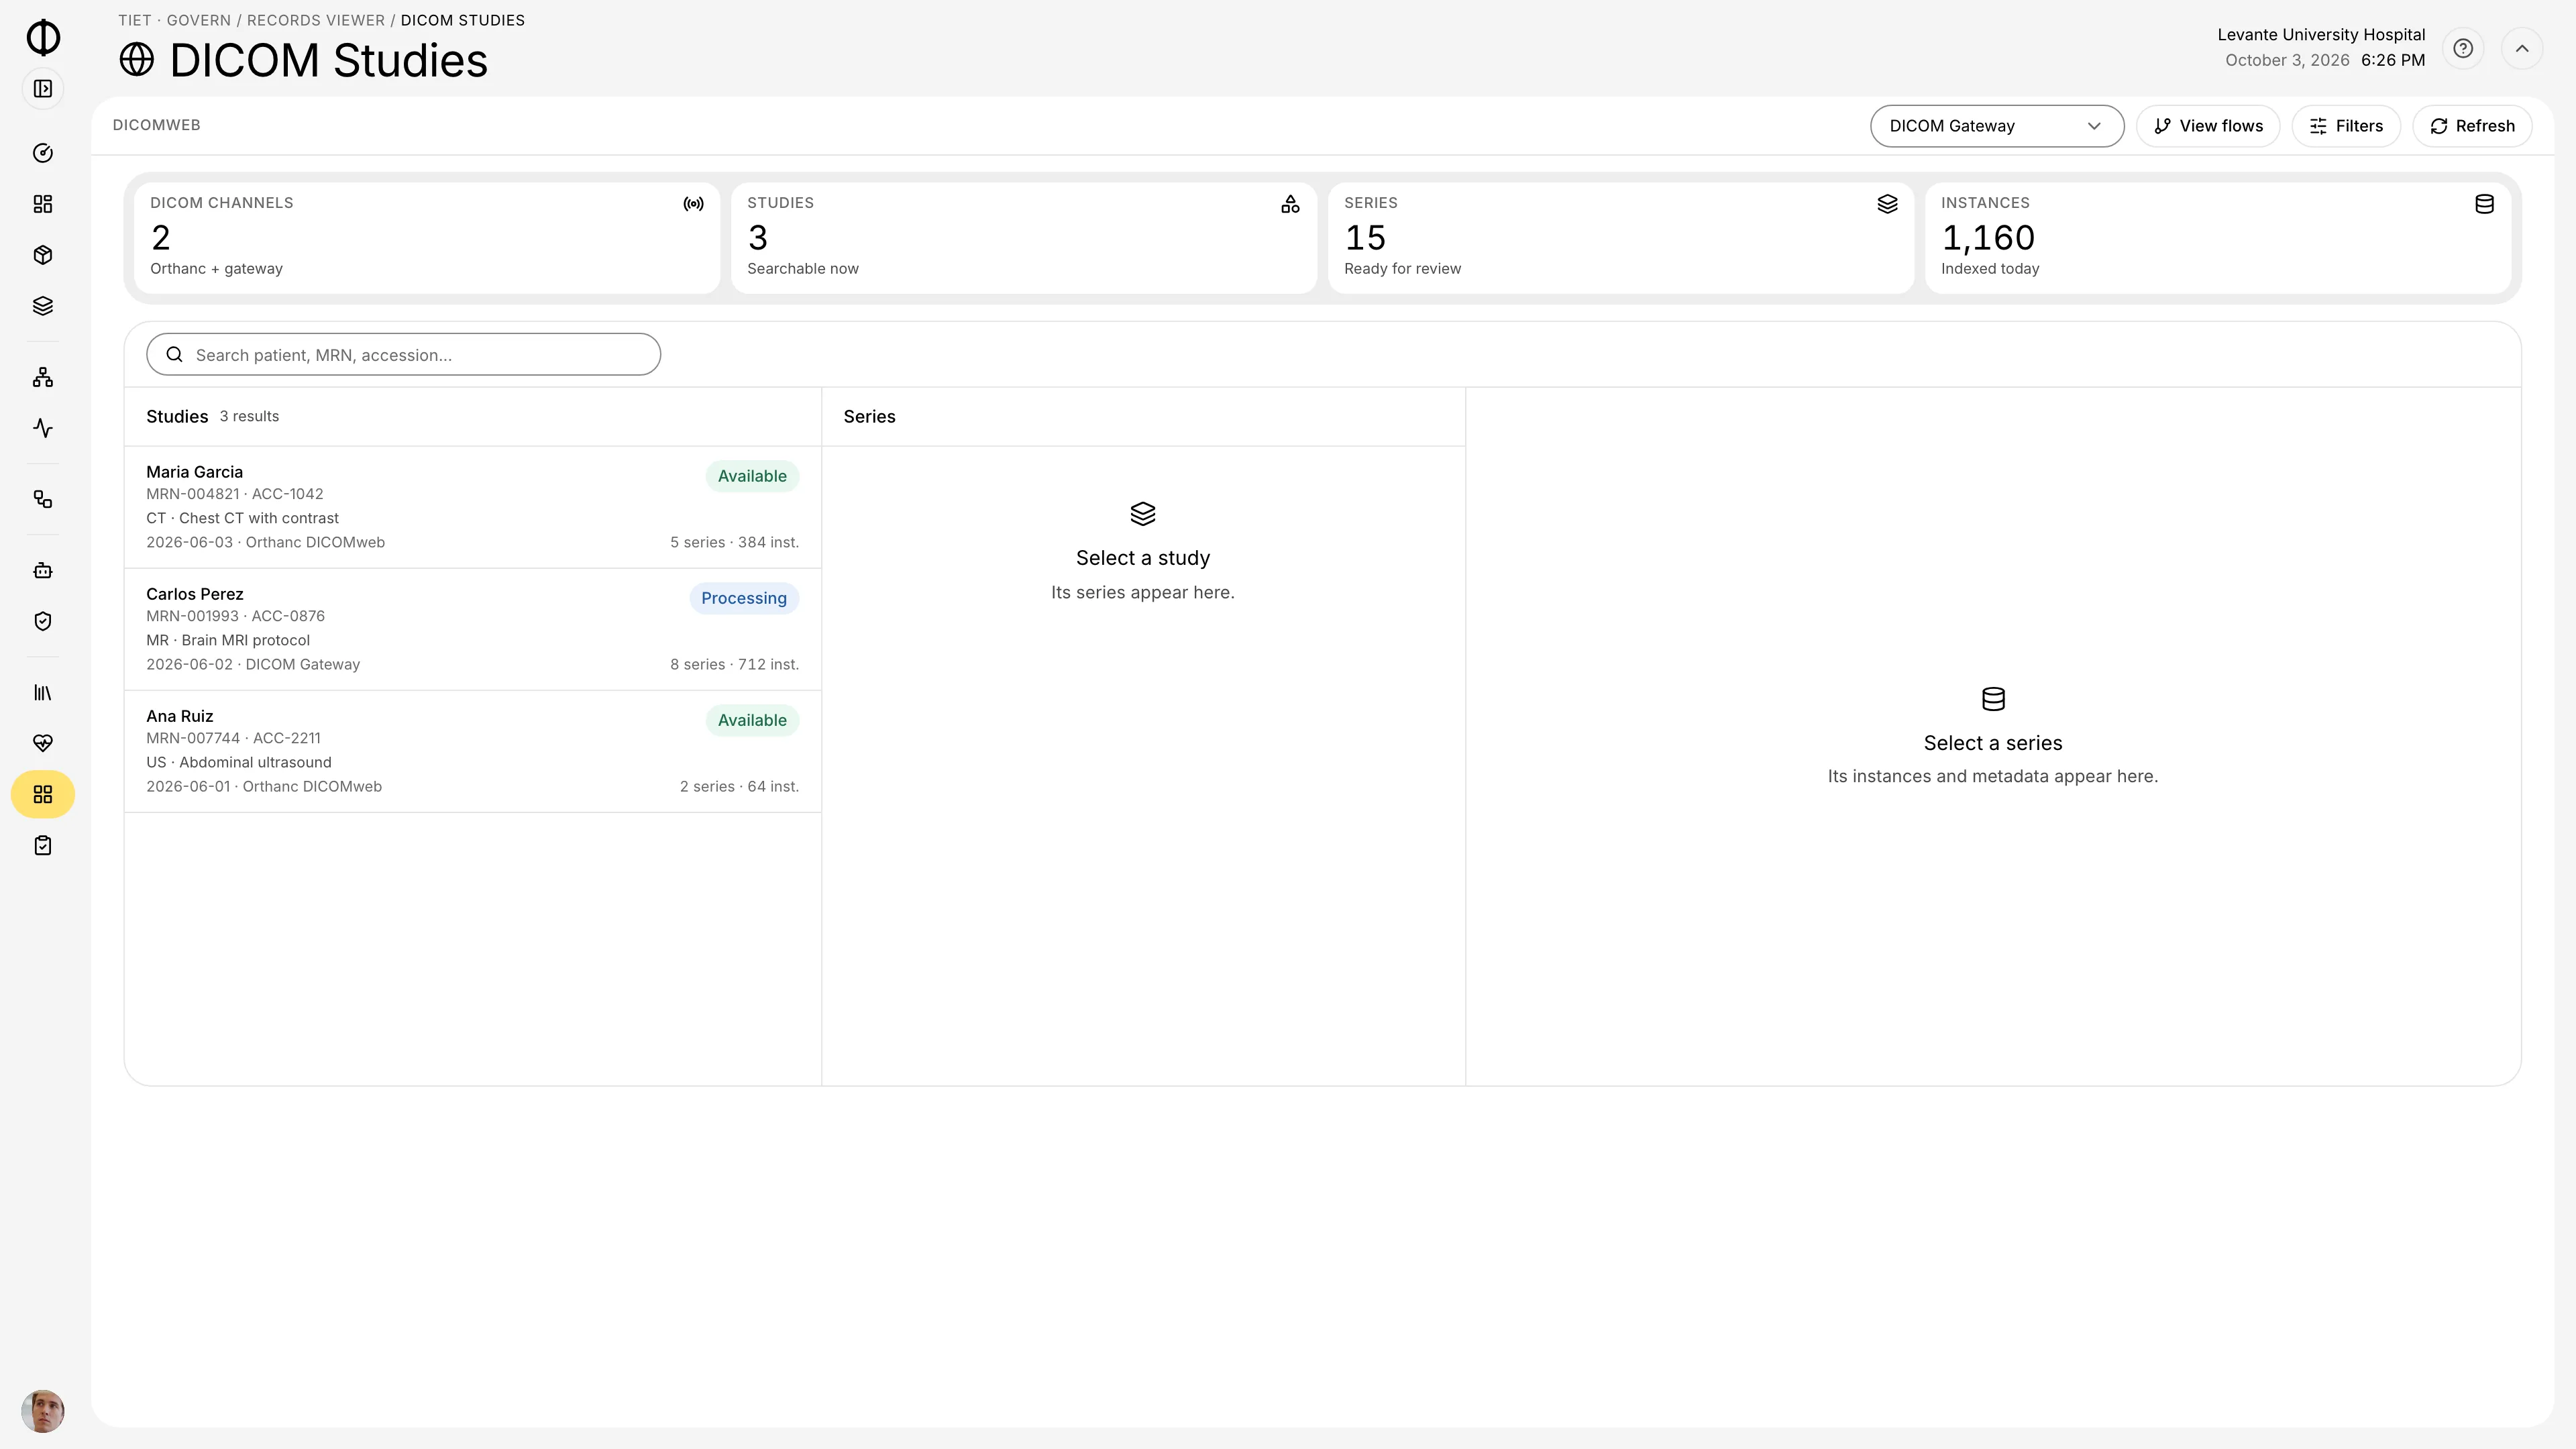
Per respondre amb honestedat necessites quatre tipus de dades que normalment viuen quatre vides diferents: la imatge de TC, la història clínica estructurada, el panell genòmic i els resultats. A Tietai entren en una sola sessió com a fonts connectades: una base de dades clínica OMOP d’un parell de milers de pacients, un PACS que extreu estudis de TC abdominal per DICOM, un panell VCF d’uns quants centenars de mostres i una exportació de la història clínica amb els informes d’alta. Res no ha sortit encara del seu sistema d’origen. Simplement són a la vista, junts, per primera vegada.
I de seguida apareix el primer problema del món real, el que coneix tot equip de recerca i que tota demo ignora: una d’aquestes fonts és plena de dades de pacients identificats. Els informes d’alta tenen noms, números d’història, dates, de tot. Aquest és just el punt on mor bona part de la velocitat de la recerca, en la cursa improvisada, nerviosa i auditada a mà per eliminar la PHI abans que ningú la pugui tocar.
La desidentificació com a primer pas, no com una cosa posterior
Així que és aquí on l’entorn comença a treballar. L’exportació identificada de la història clínica mostra un avís que no desapareix fins que es resol, i la desidentificació s’executa com una operació de primer nivell al llenç: un pipeline de desidentificació versionat que elimina la PHI, etiqueta les entitats que ha trobat (identificadors de pacient, diagnòstics, medicació) i produeix un bloc derivat net. Aquest bloc està signat: porta la identitat del pipeline, una versió i la signatura d’un clínic que certifica que el pas es va fer i va superar la revisió.
Aquest és el primer punt on el calendari s’enfonsa, i val la pena ser precisos sobre per què. No és que una màquina hagi desidentificat text; moltes eines ho fan. És que la desidentificació ara és un pas del registre de l’estudi i no una cosa que algú va fer dimarts passat en un script que ningú no va guardar. La procedència de “com sabem que això és segur de fer servir” viatja amb les dades des del primer moviment. Ningú no l’ha de reconstruir després, perquè mai no va estar separada de les dades.
A partir d’aquí pren forma la cohort neta i estructurada: uns quants centenars de pacients amb adenocarcinoma ductal en estadi II o superior, pseudonimitzats, signats, construïts una vegada i reutilitzats en tot el que ve després. Defineix la cohort una sola vegada i cada pas posterior —la lectura d’imatge, la corba de supervivència, el panell de variants— apunta a la mateixa definició. La versió del malbaratament en recerca en què tres anàlisis van fer servir en silenci tres cohorts lleugerament diferents simplement no pot passar, perquè només hi ha una cohort i tot hi està connectat.
On els agents fan la lectura
Ara, el problema del volum. Uns quants centenars de pacients volen dir desenes d’estudis de TC, amb centenars de talls cadascun, que algú ha de llegir i mesurar. És el tipus de feina que es menja el mes d’un resident investigador.
A l’entorn, un agent lector de radiologia fa la primera passada per tot el lot. Carrega cada sèrie, segmenta i mesura, contrasta amb els criteris d’inclusió de la cohort i redacta troballes estructurades (una massa hipodensa al cap del pàncrees, una mesura de dilatació del conducte, un possible contacte vascular), cadascuna etiquetada amb una puntuació de confiança. No decideix res pel seu compte en silenci. Quan arriba a un estudi on la lectura importa de debò i la confiança és només intermèdia (un possible contacte amb l’artèria mesentèrica superior just al llindar en què el mateix protocol d’imatge hauria de canviar), s’atura i pregunta. La troballa es mostra a un clínic signant amb la decisió concreta explicada, i el lot espera una resposta humana abans de continuar.
Aquesta pausa és tot el disseny en miniatura. L’agent comprimeix la part tediosa i d’alt volum de setmanes a una tarda. La persona dedica la seva escassa atenció només al grapat de decisions que de debò necessiten criteri. Velocitat i rigor deixen de ser un compromís, perquè l’agent no substitueix la decisió del clínic; li treu tot el que l’envolta excepte la decisió mateixa.
El mateix patró funciona en paral·lel per a la genòmica. Un anotador genòmic redueix el VCF al panell que importa (variants patogèniques per sobre d’un llindar de freqüència al·lèlica), i aquest panell anotat queda com una entrada bloquejada i pendent de signatura: no pot alimentar en silenci un resultat posterior fins que una persona l’hagi revisat i signat. L’anotació és ràpida; la responsabilitat és explícita.
La troballa, i per què t’hi pots refiar
Amb una cohort neta, un conjunt d’imatges llegides i un panell de variants signat, l’anàlisi de resultats és gairebé un anticlímax, i d’això es tracta. Una comparació de supervivència de Kaplan-Meier segons l’estat de resecció surt de dades ja connectades i ja fiables: un hazard ratio de 0,68, una p de log-rank de 0,004 i una mediana de supervivència global de 14,2 mesos davant de 9,1, amb 187 esdeveniments a la cohort. Un senyal real, obtingut no després d’un trimestre de manipular dades, sinó com el següent clic natural un cop aquesta manipulació es va eliminar per disseny.
I després, l’última milla que la recerca acostuma a tractar com un projecte a part: posar la troballa en context. Un agent de revisió de l’evidència elabora un informe davant de la literatura externa (els resultats de PREOPANC-2, una metaanàlisi del 2024, la guia actual de l’ESMO) i qualifica la solidesa de cada font a l’estil GRADE, perquè el senyal intern es llegeixi al costat del que el camp ja sap. L’informe està signat, anonimitzat i se situa al mateix llenç que les imatges de què va sortir.
Això és el que fa que la cadena completa valgui més que la suma dels seus passos. Cada bloc porta el seu llinatge. L’informe d’evidència remet a l’anàlisi de supervivència, que remet a la cohort, que remet a l’exportació desidentificada i a les sèries de TC, que remeten, a través de l’agent lector, a l’extracció en brut del PACS. Fes clic a qualsevol resultat i podràs resseguir enrere la font exacta en què es basa, la versió de l’eina que el va produir i el clínic que el va signar. La troballa no és una xifra en una presentació que algú et demanarà que tornis a justificar d’aquí a sis mesos. És una afirmació amb tota la seva cadena de custòdia adjunta.
Això no és documentació que escrius després. És una propietat del sistema. Cosa que vol dir que les dues coses que una organització de recerca necessita de debò d’un resultat ràpid (el podem reproduir? el podem defensar?) queden resoltes per construcció, no per arqueologia.
Per què això és el que accelera un equip
Si t’allunyes del fil, l’acceleració no ve de cap component enginyós aïllat. Ve d’eliminar els buits que abans hi havia entre els components.
L’equip no torna a integrar mai dades entre passos, perquè els passos comparteixen una columna vertebral. No torna a establir mai la confiança en un resultat, perquè la confiança hi viatja com a signatures i llinatge. No repeteix mai la desidentificació ni torna a derivar una cohort, perquè totes dues són objectes versionats de primer nivell, construïts una vegada. Només dedica criteri humà allà on cal criteri, perquè els agents absorbeixen el volum i retornen les decisions. I quan un estudi abasta més d’un hospital, les mateixes garanties es mantenen entre centres: amb la malla de Tiet · Connect, cada pas s’executa allà on està permès i només creuen una frontera resultats desidentificats i derivats, de manera que una xarxa de recerca pot compartir la troballa sense que cap centre comparteixi una història de pacient.
Res d’això no substitueix l’investigador. Una persona defineix la pregunta, respon les consultes que escalen els agents i signa els resultats. L’entorn fins i tot mostra quan dos editors són alhora a les notes de criteris d’inclusió, perquè la recerca és un esport d’equip i el registre ho ha de reflectir. El que canvia és on va el temps de l’investigador. Menys a la lampisteria, les exportacions, tornar a teclejar i reconstruir la procedència. Més a la ciència de debò.
El sector es va passar anys donant als equips de recerca millors eines (un visor millor, un paquet estadístic millor, un model d’anotació millor) i després els va deixar carregant a mà les dades entre els buits d’aquestes eines. Els buits sempre van ser on se n’anava el temps. Un sistema integrat no fa que cap pas concret sigui radicalment més ràpid. Fa que desapareguin els traspassos. I quan desapareixen els traspassos, una pregunta que abans portava un trimestre es pot respondre, amb tota la seva procedència intacta, en qüestió de dies.
Aquest és l’entorn de recerca en què Tietai s’està construint per convertir-se: no una eina més ràpida al munt, sinó el llenç que convertirà el munt en un únic sistema, amb la ciència en mans humanes i la maquinària honesta.
Roberto Cruz
CEO, Tietai — The Healthcare Execution Platform.
Porta’ns el teu pitjor problema de dades o d’integració i definirem una Proof of Value a la seva mida. contact@tiet.ai