Les équipes de recherche médicale ne manquent pas de données. Elles manquent de données connectées. L’imagerie est dans le PACS. Le tableau clinique est dans le DPI, dont la moitié est enfermée dans des comptes rendus de sortie en texte libre. La génomique est un fichier VCF sur un partage du laboratoire. Les chiffres de survie sortent d’un logiciel statistique qui ne communique avec rien de tout cela. La littérature qui remet le tout en contexte vit dans cent onglets de navigateur.
Roberto Cruz
10 juillet 2026
Publié à l’origine sur LinkedIn
Chacun de ces systèmes fait son travail. Le problème, c’est l’espace entre eux. Une question de recherche qui devrait prendre un après-midi prend un trimestre, parce que l’essentiel du trimestre passe à déplacer des données à la main d’un trou à l’autre : exporter, réidentifier qui est qui, coller une définition de cohorte dans trois outils qui définissent chacun une cohorte différemment, recalculer un chiffre que quelqu’un a déjà calculé le mois dernier et (discrètement, à grands frais) perdre le fil de l’origine réelle de chaque résultat.
Ce qui accélère une équipe de recherche, ce n’est pas un modèle plus rapide. C’est de combler les trous. Un endroit où l’imagerie, le dossier, les variants, les statistiques et les preuves sont sur le même canevas, où un résultat porte sa propre histoire, et où la machinerie de l’étude (désidentification, logique de cohorte, annotation, signature) fait partie de la surface au lieu d’être une pile de tâches annexes. C’est ce que nous avons voulu faire de l’environnement de recherche de Tietai, et le moyen le plus rapide de montrer ce qu’il change est de suivre une seule étude, des données brutes jusqu’à un résultat défendable devant un comité de revue.
Un fil : une cohorte de cancer du pancréas
Prenons une question réaliste. Le traitement néoadjuvant modifie-t-il la survie dans l’adénocarcinome canalaire du pancréas résécable, et pouvons-nous voir le signal chez nos propres patients avant de concevoir un essai autour ?
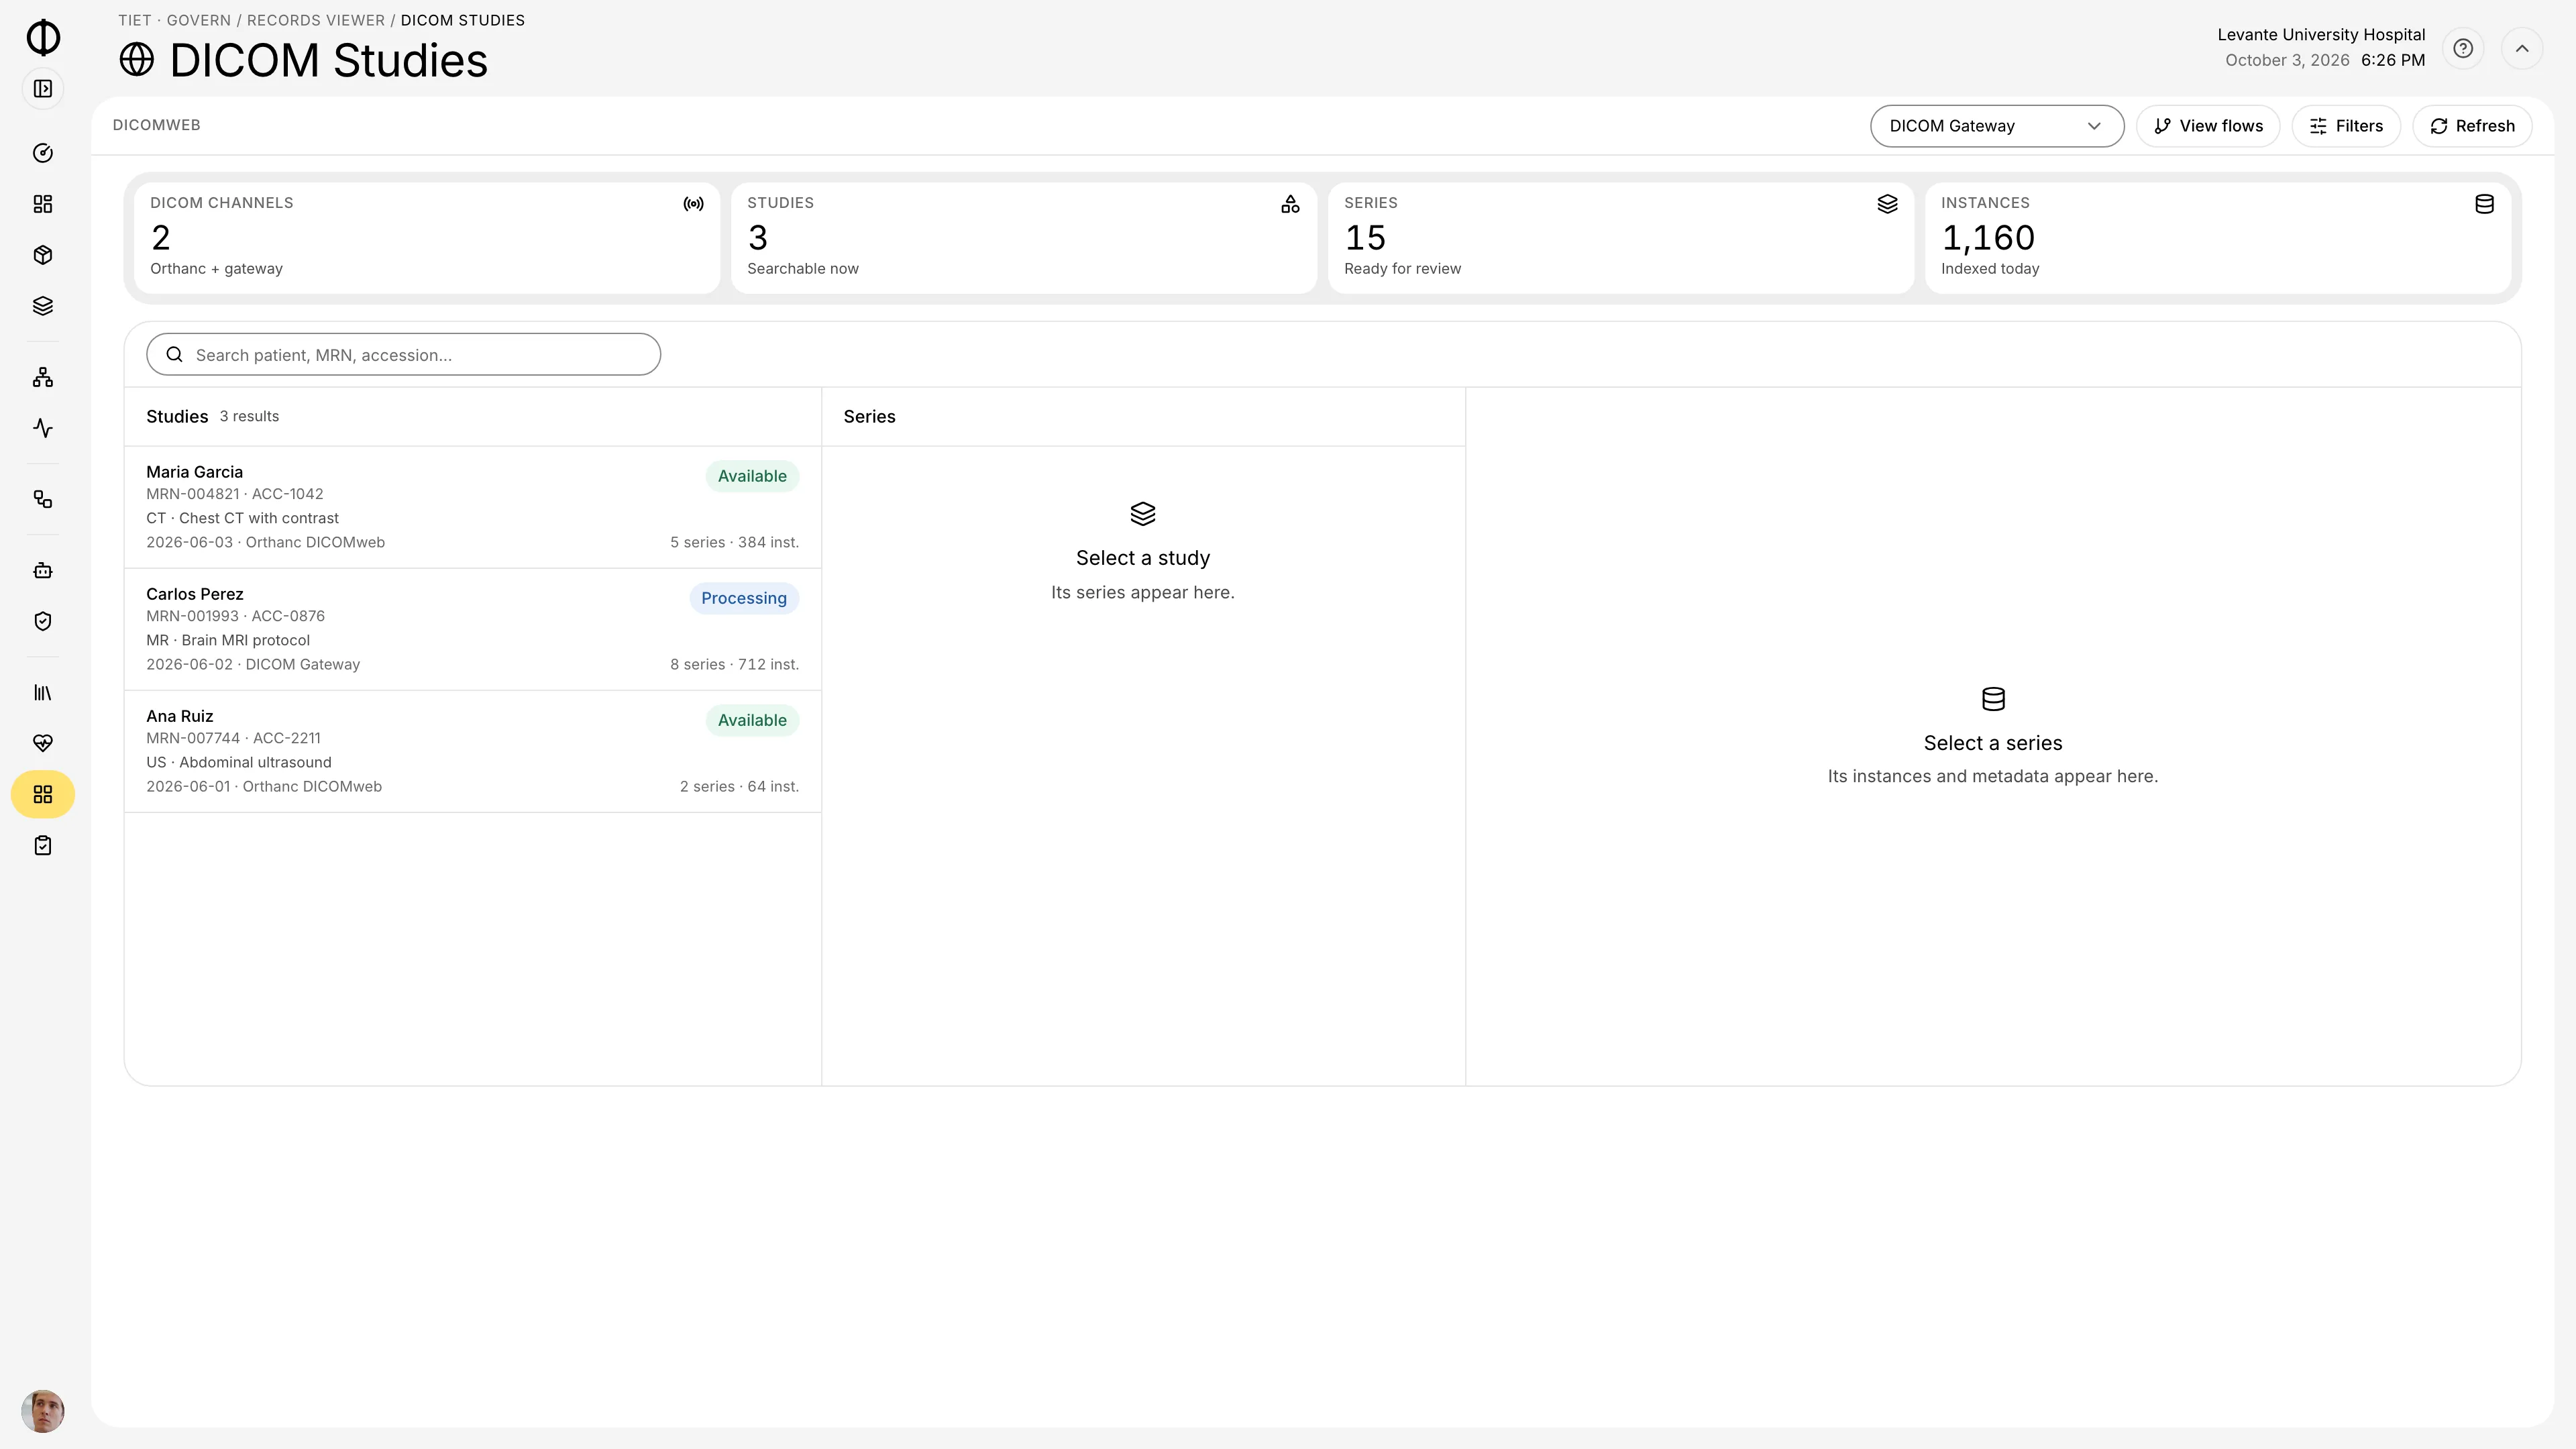
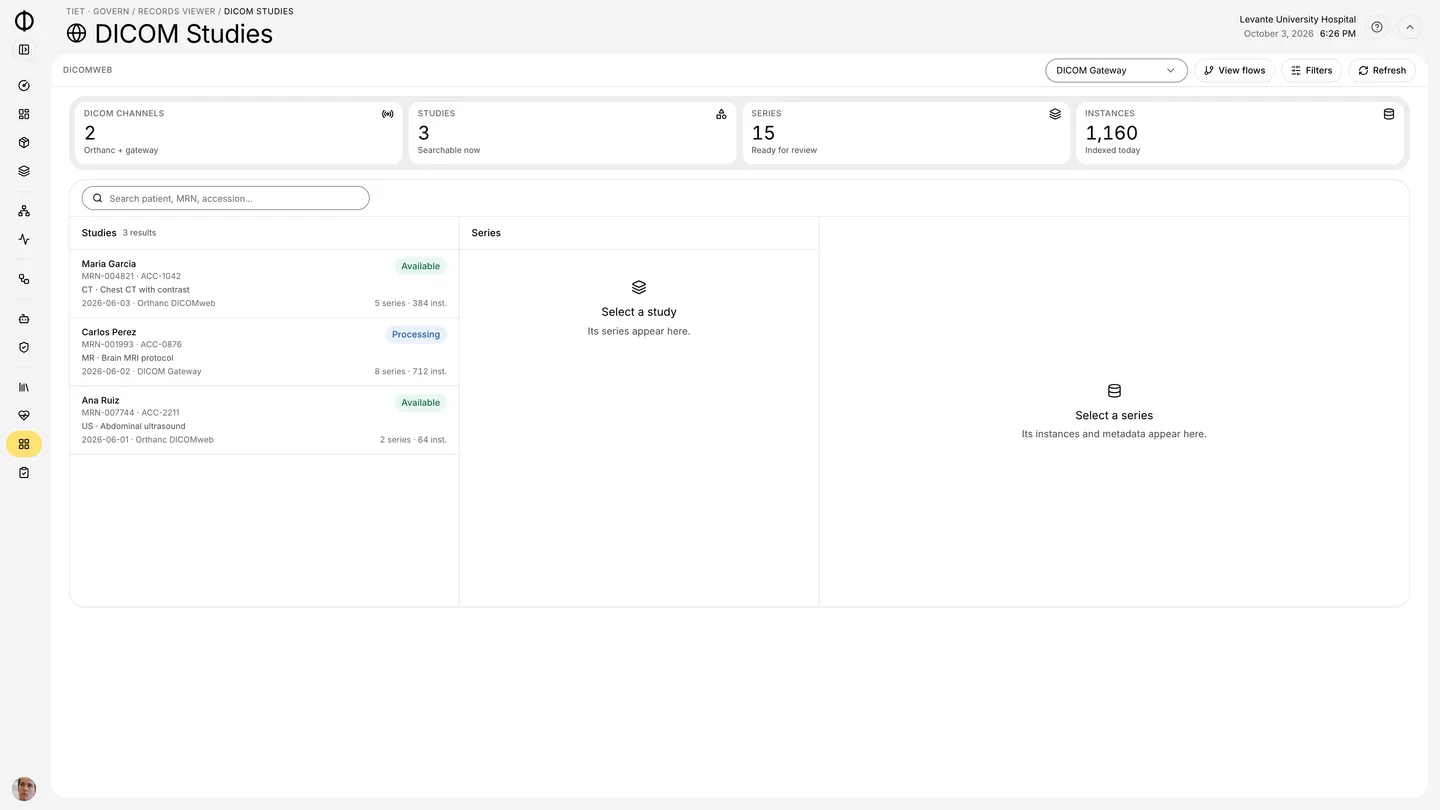
Pour répondre honnêtement, il faut quatre types de données qui vivent normalement quatre vies différentes : l’imagerie scanner, le dossier clinique structuré, le panel génomique et les résultats cliniques. Sur Tietai, elles arrivent dans une seule session comme sources connectées : une base de données clinique OMOP de quelques milliers de patients, un PACS qui récupère des scanners abdominaux en DICOM, un panel VCF de quelques centaines d’échantillons et un export du DPI avec les comptes rendus de sortie. Rien n’a encore quitté son système d’origine. Elles sont simplement visibles, ensemble, pour la première fois.
Et immédiatement surgit le premier problème du monde réel, celui que toute équipe de recherche connaît et que toute démo ignore : l’une de ces sources est pleine de données patients identifiantes. Les comptes rendus de sortie contiennent noms, numéros de dossier, dates, tout. C’est précisément là que meurt une grande partie de la vitesse de la recherche, dans la course improvisée, anxieuse et vérifiée à la main pour supprimer les PHI avant que quiconque ait le droit d’y toucher.
La désidentification comme première étape, pas comme une réflexion après coup
C’est donc là que l’environnement se met au travail. L’export identifiant du DPI reçoit un bandeau qui ne disparaît pas tant qu’il n’est pas traité, et la désidentification s’exécute comme une opération à part entière sur le canevas : un pipeline de désidentification versionné qui supprime les PHI, étiquette les entités trouvées (identifiants patients, diagnostics, médicaments) et produit un bloc dérivé propre. Ce bloc est signé : il porte l’identité du pipeline, une version et la signature d’un clinicien attestant que l’étape a eu lieu et a passé la revue.
C’est le premier endroit où le calendrier s’effondre, et il vaut la peine d’être précis sur la raison. Ce n’est pas qu’une machine a désidentifié du texte ; beaucoup d’outils le font. C’est que la désidentification est désormais une étape du registre de l’étude et non quelque chose que quelqu’un a fait mardi dernier dans un script que personne n’a conservé. La provenance du « comment sait-on que c’est sûr à utiliser » voyage avec les données dès le premier mouvement. Personne n’a à la reconstruire plus tard, parce qu’elle n’a jamais été séparée des données.
À partir de là, la cohorte propre et structurée prend forme : quelques centaines de patients atteints d’adénocarcinome canalaire de stade II ou plus, pseudonymisés, signés, constitués une fois et réutilisés partout en aval. Définissez la cohorte une seule fois, et chaque étape suivante — la lecture d’imagerie, la courbe de survie, le panel de variants — pointe vers la même définition. Le gaspillage où trois analyses ont discrètement utilisé trois cohortes légèrement différentes ne peut tout simplement pas se produire, parce qu’il n’y a qu’une cohorte et que tout y est relié.
Là où les agents font la lecture
Vient ensuite le problème du volume. Quelques centaines de patients, ce sont des dizaines de scanners, avec des centaines de coupes chacun, que quelqu’un doit réellement lire et mesurer. C’est le genre de travail qui dévore le mois d’un chercheur en formation.
Dans l’environnement, un agent de lecture radiologique fait le premier passage sur tout le lot. Il charge chaque série, segmente et mesure, vérifie les critères d’inclusion de la cohorte et rédige des constats structurés (une masse hypodense de la tête du pancréas, une mesure de dilatation canalaire, un contact vasculaire suspecté), chacun accompagné d’un score de confiance. Il ne décide rien en silence par lui-même. Quand il tombe sur un examen où la lecture compte vraiment et où la confiance n’est que moyenne (un possible contact avec l’artère mésentérique supérieure, au seuil même où le protocole d’imagerie devrait changer), il s’arrête et demande. Le constat est présenté à un clinicien signataire avec la décision précise à prendre, et le lot attend une réponse humaine avant de continuer.
Cette pause, c’est toute la conception en miniature. L’agent comprime la partie fastidieuse et volumineuse de plusieurs semaines à un après-midi. L’humain ne consacre son attention rare qu’à la poignée de décisions qui exigent vraiment du jugement. Vitesse et rigueur cessent d’être un compromis, parce que l’agent ne remplace pas la décision du clinicien ; il dégage tout ce qui l’entoure, sauf la décision elle-même.
Le même schéma tourne en parallèle pour la génomique. Un annotateur génomique réduit le VCF au panel pertinent (variants pathogènes au-dessus d’un seuil de fréquence allélique), et ce panel annoté est conservé comme une entrée verrouillée, en attente de signature : il ne peut pas alimenter en silence un résultat en aval tant qu’un humain ne l’a pas revu et signé. L’annotation est rapide ; la responsabilité est explicite.
Le résultat, et pourquoi vous pouvez vous y fier
Avec une cohorte propre, un jeu d’imagerie lu et un panel de variants signé, l’analyse des résultats est presque une formalité, et c’est le but. Une comparaison de survie de Kaplan-Meier selon le statut de résection découle de données déjà connectées et déjà fiables : un hazard ratio de 0,68, un p du log-rank de 0,004, une survie globale médiane de 14,2 mois contre 9,1, sur 187 événements dans la cohorte. Un vrai signal, obtenu non pas après un trimestre de manipulation des données, mais comme le clic suivant naturel une fois cette manipulation supprimée par conception.
Puis vient le dernier kilomètre que la recherche traite généralement comme un projet à part : mettre le résultat en contexte. Un agent de revue des preuves rédige une synthèse au regard de la littérature externe (les résultats de PREOPANC-2, une méta-analyse de 2024, les recommandations actuelles de l’ESMO) et note la solidité de chacune selon l’approche GRADE, pour que le signal interne soit lu à la lumière de ce que la discipline sait déjà. La synthèse est signée, anonymisée, et se trouve sur le même canevas que l’imagerie dont elle provient.
Voici ce qui fait que la chaîne entière vaut plus que la somme de ses étapes. Chaque bloc porte sa lignée. La synthèse des preuves remonte à l’analyse de survie, qui remonte à la cohorte, qui remonte à l’export désidentifié et aux séries scanner, qui remontent, via l’agent de lecture, à l’extraction brute du PACS. Cliquez sur n’importe quel résultat et vous remontez à la source exacte sur laquelle il repose, à la version de l’outil qui l’a produit et au clinicien qui l’a signé. Le résultat n’est pas un chiffre dans une présentation qu’on vous demandera de rejustifier dans six mois. C’est une affirmation accompagnée de toute sa chaîne de traçabilité.
Ce n’est pas une documentation qu’on écrit après coup. C’est une propriété du système. Ce qui signifie que les deux choses dont une organisation de recherche a vraiment besoin d’un résultat rapide (peut-on le reproduire, peut-on le défendre) sont résolues par construction, et non par archéologie.
Pourquoi c’est cela qui accélère une équipe
Prenez du recul sur ce fil : l’accélération ne vient d’aucun composant astucieux isolé. Elle vient de la disparition des trous qui séparaient les composants.
L’équipe ne réintègre jamais les données entre les étapes, parce que les étapes partagent une colonne vertébrale. Elle ne rétablit jamais la confiance dans un résultat, parce que la confiance voyage avec lui sous forme de signatures et de lignée. Elle ne refait jamais la désidentification ni ne recalcule une cohorte, parce que les deux sont des objets versionnés à part entière, construits une fois. Elle ne mobilise le jugement humain que là où il est nécessaire, parce que les agents absorbent le volume et rendent les décisions. Et quand une étude couvre plusieurs hôpitaux, les mêmes garanties valent entre les sites : avec le maillage Tiet · Connect, chaque étape s’exécute là où elle est autorisée et seuls des résultats désidentifiés et dérivés franchissent une frontière, si bien qu’un réseau de recherche peut partager le résultat sans qu’aucun site ne partage un dossier patient.
Rien de tout cela ne remplace le chercheur. Une personne définit la question, répond aux sollicitations que les agents font remonter et signe les résultats. L’environnement montre même quand deux personnes éditent en même temps les notes sur les critères d’inclusion, parce que la recherche est un sport d’équipe et que le registre doit le refléter. Ce qui change, c’est où va le temps du chercheur. Moins de tuyauterie, d’exports, de ressaisie et de reconstitution de la provenance. Plus de science véritable.
Le secteur a passé des années à donner aux équipes de recherche de meilleurs outils (une meilleure visionneuse, un meilleur logiciel statistique, un meilleur modèle d’annotation), puis les a laissées porter les données à la main entre ces outils. C’est toujours dans ces trous que le temps disparaissait. Un système intégré ne rend aucune étape spectaculairement plus rapide. Il fait disparaître les passages de relais. Et quand ils disparaissent, une question qui prenait un trimestre peut trouver sa réponse, avec toute sa provenance intacte, en quelques jours.
C’est l’environnement de recherche que Tietai est en train de devenir : non pas un outil plus rapide dans la pile, mais le canevas qui fera de la pile un seul système, avec une science qui reste humaine et une machinerie qui reste honnête.
Roberto Cruz
CEO, Tietai — The Healthcare Execution Platform.
Apportez-nous votre pire problème de données ou d’intégration, et nous cadrerons un Proof of Value autour. contact@tiet.ai